機能 › ハーネス(AI の道具立て)メニュー:ハーネス(AI の道具立て) › ハーネスの設計 › 試してから選ぶ
試してから選ぶ
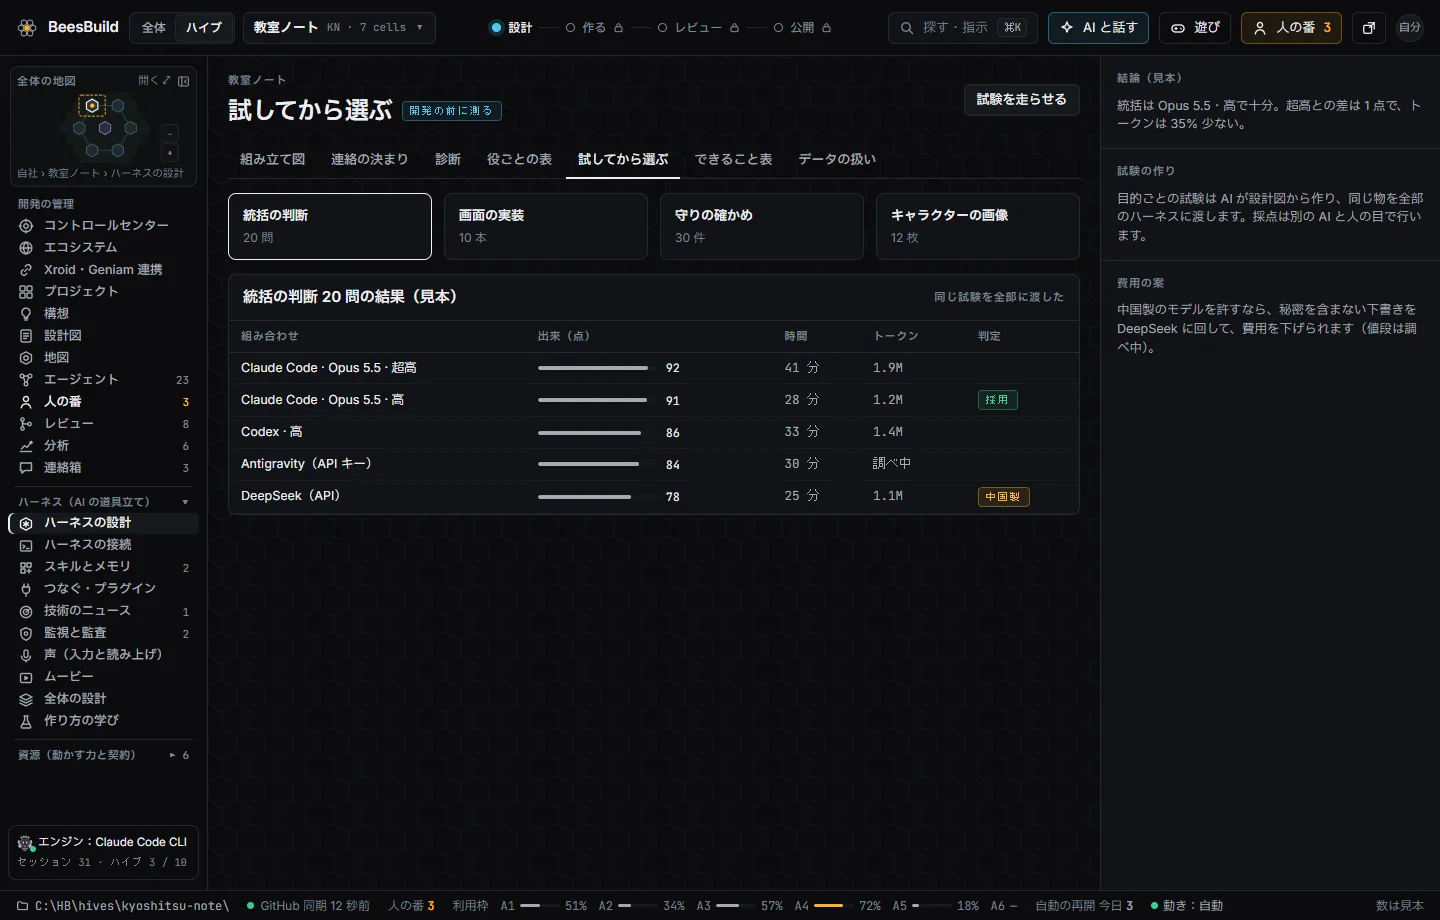
どのハーネスとどの AI が自分の仕事に合うかは、評判では決めません。開発の前に、同じ試験を全部の候補に流し、出来・時間・トークン・費用を並べて比べます。決めた結果は、ハーネスの設計の役ごとの表に入ります。
目的ごとの試験
試験は、役の目的ごとに作ります。AI が設計図から作るので、そのハイブで本当にやる仕事に近い問いになります。
| 試験の例 | 中身 | 数 |
|---|---|---|
| 統括の判断 | 仕事の分け方・順番・止める所の判断 | 20 問 |
| 画面の実装 | 設計図の画面を、決まった部品で作る | 10 本 |
| 守りの点検 | 決まりに外れたコードを見つける | 30 件 |
| キャラクターの画像 | ブランドの決めに合った絵を描く | 12 枚 |
同じ物を、全部のハーネスと AI の組み合わせに渡します。採点は、作った AI とは別の AI と、人の目で行います。
試す流れ
- 目的を選ぶ:役ごとの表で、比べたい役を選びます。
- 試験を作る:AI が設計図から、その役の試験を作ります。人は問いを足したり外したりできます。
- 走らせる:「試験を走らせる」を押すと、同じ試験が全部の候補に流れます。
- 採点する:別の AI が採点し、人が見て直します。
- 比べる:出来・時間・トークン・費用を並べます。
- 決める:採る組み合わせに「採用」を付けます。役ごとの表の状態が「試した」になります。
結果の読み方
統括の判断 20 問の結果の見本です。数は見本です。
| 組み合わせ | 出来(点) | 時間 | トークン | 判定 |
|---|---|---|---|---|
| Claude Code・Opus 5.5・超高 | 92 | 41 分 | 1.9M | — |
| Claude Code・Opus 5.5・高 | 91 | 28 分 | 1.2M | 採用 |
| Codex・高 | 86 | 33 分 | 1.4M | — |
| Antigravity(API キー) | 84 | 30 分 | 調べ中 | — |
| DeepSeek(API) | 78 | 25 分 | 1.1M | 中国製 |
- いちばん点の高い組み合わせが、いつも答えになるとは限りません。見本では、「超高」と「高」の差は 1 点で、「高」の方が時間は 3 分の 2、トークンは 35% 少なく済みました。統括は「高」で足りる、と読みます。
- 「中国製」の札は、データの扱いの既定が違うことを示します。秘密を含まない下書きだけを回せば、費用を下げられます(データの扱い)。
- 測れていない数は「調べ中」と出し、0 や推測で埋めません。
何を比べるか
| 比べる物 | 中身 |
|---|---|
| 出来 | 採点の点。問いごとの正しさと、決まりを守ったか |
| 時間 | 走らせてから全部の答えが出るまで |
| トークン | 入力と出力の合計 |
| 費用 | トークンと値段の台帳から出した見込み。契約の枠で動く物は、使った枠の割合で出す |
| 規約と守り | できること表の「規約の注意」と「安全」の欄(ハーネスの設計) |
同じ試験は、ハーネスの版が上がった時や、新しいモデルが出た時に流し直せます。技術のニュースで新しいモデルが出たと分かった時は、試験の候補に足す提案が届きます(技術のニュースと見張り)。
データの形
| 型 | 中身 |
|---|---|
HbEngineRun | 1 回の走り(ハーネス・モデル・思考の量・時間・トークン・結果) |
HbRunEvent | 走りの出来事の流れ |
HbCapability | できること表の 1 行 |